Современная компания редко работает на одном сервере и паре рабочих компьютеров. Почта, сайт, телефония, CRM, бухгалтерские сервисы, удаленные рабочие места, облачные базы и внутренние приложения завязаны друг на друга плотнее, чем кажется снаружи.
Когда один элемент цепочки начинает отвечать медленнее или уходит в ошибку, пользователи обычно видят только итог: страница не открывается, заявка не проходит, сотрудник не может войти в нужную систему. Поэтому грамотный мониторинг становится не технической роскошью, а способом управлять устойчивостью бизнеса.
Зачем компании нужен постоянный контроль ИТ-среды
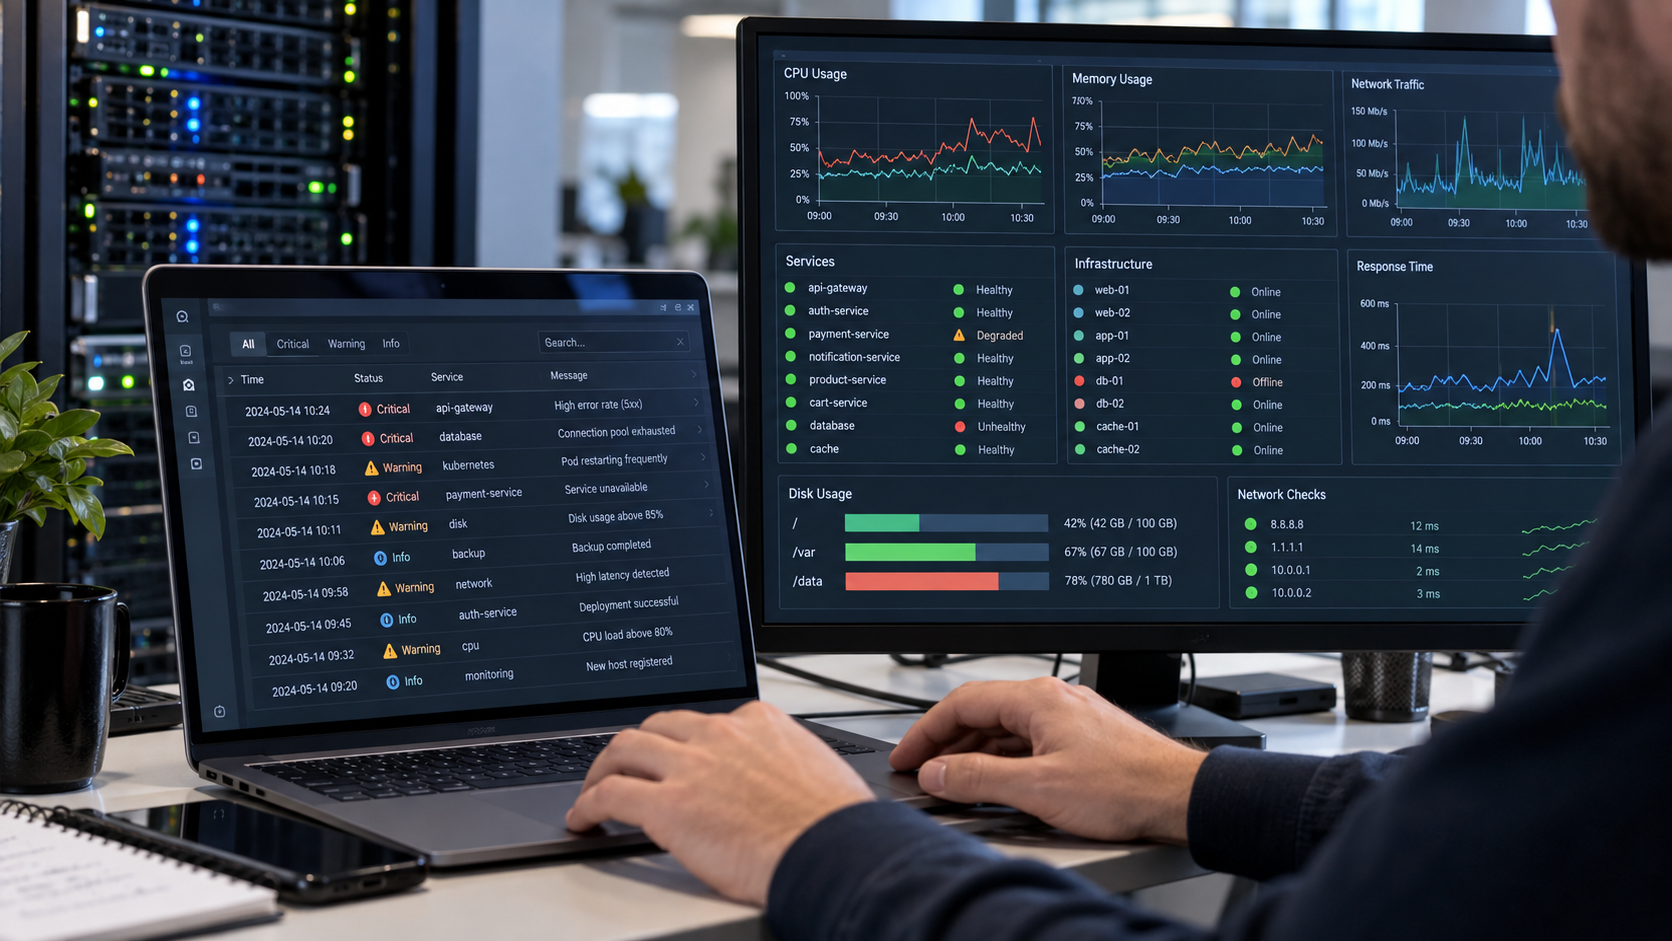
Главная задача мониторинга не в том, чтобы собрать как можно больше графиков. Он нужен для раннего обнаружения признаков проблемы: роста задержек, нехватки диска, перегрева оборудования, ошибок в приложениях, отказов сетевых узлов или нештатной нагрузки.
Если такие сигналы замечены заранее, у администратора остается время спокойно разобраться в причине. В противном случае команда узнает о сбое уже от клиентов, руководителей или отдела продаж, а восстановление превращается в срочную операцию под давлением.
Особенно важен этот подход для распределенных систем. Один сервис может быть технически доступен, но зависеть от базы данных, очереди сообщений, DNS, внешнего API или сетевого маршрута. Без общей картины такие связи трудно отследить вручную.
Что именно стоит отслеживать
Базовый уровень контроля обычно включает доступность серверов, сетевых устройств, сайтов и приложений. Но одной проверки «отвечает или не отвечает» недостаточно: полезнее смотреть на качество ответа и состояние внутренних ресурсов.
Для серверов важны загрузка процессора, оперативная память, свободное место на дисках, операции ввода-вывода, состояние RAID, системные журналы и ошибки служб. Для сетевой части проверяют задержки, потери пакетов, доступность шлюзов, VPN, балансировщиков и каналов связи.
Отдельного внимания требуют бизнес-приложения. Если сайт открывается, но форма заказа не отправляет данные, для клиента сервис фактически не работает. Поэтому мониторинг должен включать сценарии, которые повторяют реальные действия пользователя.
Как строится понятная система оповещений
Сильная система мониторинга отличается не количеством уведомлений, а их точностью. Если дежурный специалист получает десятки одинаковых сообщений без приоритета, он быстро перестает воспринимать их как полезный сигнал.
Правильнее разделять события по критичности. Одни требуют немедленной реакции, другие можно разобрать в рабочее время, третьи нужны только для статистики и планирования. Такой подход помогает не пропускать действительно опасные изменения.
Например, кратковременный скачок нагрузки может быть обычным пиком активности. Но если одновременно растет время ответа приложения, увеличивается очередь запросов и заканчивается место на диске, это уже повод для срочного вмешательства.
Почему важны исторические данные
Мониторинг полезен не только в момент аварии. Накопленные метрики показывают, как инфраструктура меняется со временем: где растет нагрузка, какие сервисы чаще всего дают сбои, когда пора расширять мощности и какие изменения повлияли на стабильность.
История помогает отличить случайную проблему от системной. Если база данных регулярно замедляется в конце месяца, это может быть связано с отчетностью. Если сайт проседает после рекламных кампаний, нужно заранее готовить ресурсы к таким периодам.
Для руководителя эти данные тоже ценны. Они переводят разговор об ИТ из области субъективных жалоб в конкретные показатели: доступность, время реакции, число инцидентов, длительность простоя и динамику нагрузки.
Мониторинг как часть процесса эксплуатации
Технический контроль работает лучше, когда он встроен в повседневные процессы. После обновления сайта, переноса сервера или изменения сетевой схемы важно проверить не только факт запуска, но и то, как изменилась работа системы под нагрузкой.
Поэтому мониторинг полезно связывать с журналом изменений. Если после обновления выросло время ответа или появились ошибки, команда быстрее найдет источник проблемы. Без такой связи приходится вручную вспоминать, что именно менялось в последние часы или дни.
На практике компаниям удобно использовать централизованный мониторинг инфраструктуры it, где события, метрики и проверки собираются в единую картину. Это снижает зависимость от ручных обходов и позволяет быстрее понимать, какой узел действительно влияет на сервис.
Какие ошибки мешают получить пользу
Первая распространенная ошибка — отслеживать только серверы, забывая о прикладном уровне. Сервер может быть включен, но приложение на нем уже не выполняет свою задачу. Пользователю важен результат, а не формальная доступность машины.
Вторая ошибка — оставлять пороги по умолчанию. У каждой системы свой нормальный режим работы. Для одного проекта высокая загрузка процессора допустима, для другого уже означает деградацию. Пороги нужно настраивать по реальной статистике.
Третья ошибка — не назначать ответственных за реакции. Уведомление само по себе ничего не исправляет. Должен быть понятный маршрут: кто получает сигнал, как подтверждает инцидент, где фиксирует действия и когда передает проблему дальше.
Как начать без хаоса
Внедрение лучше начинать с критичных сервисов. Сначала стоит перечислить системы, простой которых сразу влияет на деньги, клиентов или выполнение обязательств. Для них задают проверки доступности, качества ответа и ключевых внутренних зависимостей.
Затем добавляют инфраструктурные метрики, журналы и прикладные сценарии. На этом этапе важно не пытаться охватить все сразу. Гораздо полезнее настроить десять точных проверок, чем сотню шумных уведомлений без понятного владельца.
После первых недель эксплуатации пороги и правила стоит пересмотреть. Часть уведомлений окажется лишней, часть потребует повышения приоритета, а некоторые проверки придется расширить. Это нормальная настройка системы под живую инфраструктуру.
Что получает бизнес
Хорошо настроенный мониторинг сокращает время реакции на инциденты и помогает предотвращать часть сбоев до того, как они станут заметны клиентам. Команда видит не отдельные жалобы, а структуру проблемы и ее влияние на сервисы.
Кроме того, появляется база для планирования. Решения о расширении каналов, переносе приложений, обновлении оборудования или изменении архитектуры можно принимать на основе фактов, а не ощущения, что «система иногда тормозит».
В итоге мониторинг становится частью зрелой эксплуатации: он помогает поддерживать доступность, распределять ответственность, доказывать качество работы ИТ и спокойнее проходить периоды роста нагрузки.